代码
outliers_test(
  data, col, method = c("grubbs", "esd", "dixon", "iqr"), ...
)
normal_test(
  data, col,
  method = c("auto", "shapiro", "sw", "ad", "lillie", "cvm"),
  level = 0.95
)异常值和分布检验用于发现数据质量、实验过程或模型假设中的问题。它们是分析前的诊断工具,不是自动删除数据或自动判定产品合格的工具。
本文统一介绍独立数据检验函数 outliers_test()、normal_test(),以及对 mcr 和 precision 对象使用的 outlier()、normal() 方法。所有结论都必须回查原始记录,并保留包含/不包含异常观测的敏感性分析。
异常值检验只生成候选标记,不执行删除;正态性检验的原假设是特定分布,未拒绝不等于证明正态。方法、显著性水平、最大异常值数和尾部方向应在查看结果前确定。对象级方法可能检验的是配对差值或分样本序列,统计单位必须与研究设计一致。
| 函数 | 主要用途 |
|---|---|
outliers_test() |
对普通数据列执行 Grubbs、ESD、Dixon 或 IQR 检验 |
normal_test() |
对普通数据列执行 Shapiro、AD、Lilliefors 或 CvM 检验 |
outlier() |
对 mcr 或 precision 对象标记候选异常值 |
normal() |
对 precision 对象执行正态性诊断 |
plot() |
绘制检验对象或分析对象的诊断图 |
outliers_test(
data, col, method = c("grubbs", "esd", "dixon", "iqr"), ...
)
normal_test(
data, col,
method = c("auto", "shapiro", "sw", "ad", "lillie", "cvm"),
level = 0.95
)| 方法 | 核心定义 | 主要边界 |
|---|---|---|
| Grubbs | \(G=\max|x_i-\bar x|/s\) | 一次最多标记一个;alpha 控制检验 |
| generalized ESD | 逐步移除最大标准化偏差,比较每步 \(R_i\) 与临界值 | r 是最大候选数,默认 min(5,n-2) |
| Dixon | 端部间距与全距之比 \(Q\) | 仅 \(3\le n\le30\);alpha 仅 0.01 或 0.05 |
| IQR | 小于 \(Q_1-kIQR\) 或大于 \(Q_3+kIQR\) | 描述性规则;coef 默认 1.5 |
函数忽略缺失和非有限值,但 indices 返回原始向量的 1 起始位置。Grubbs、ESD 和 Dixon 依赖独立、近似正态等假设;IQR 不作正态假设,但也不是概率显著性检验。
normal_test(method="auto") 的确定性映射为:
| 有限样本量 | 实际方法 |
|---|---|
| \(n<3\) | 不检验 |
| \(3\le n\le50\) | Shapiro–Wilk |
| \(51\le n\le5000\) | Anderson–Darling |
| \(n>5000\) | Lilliefors |
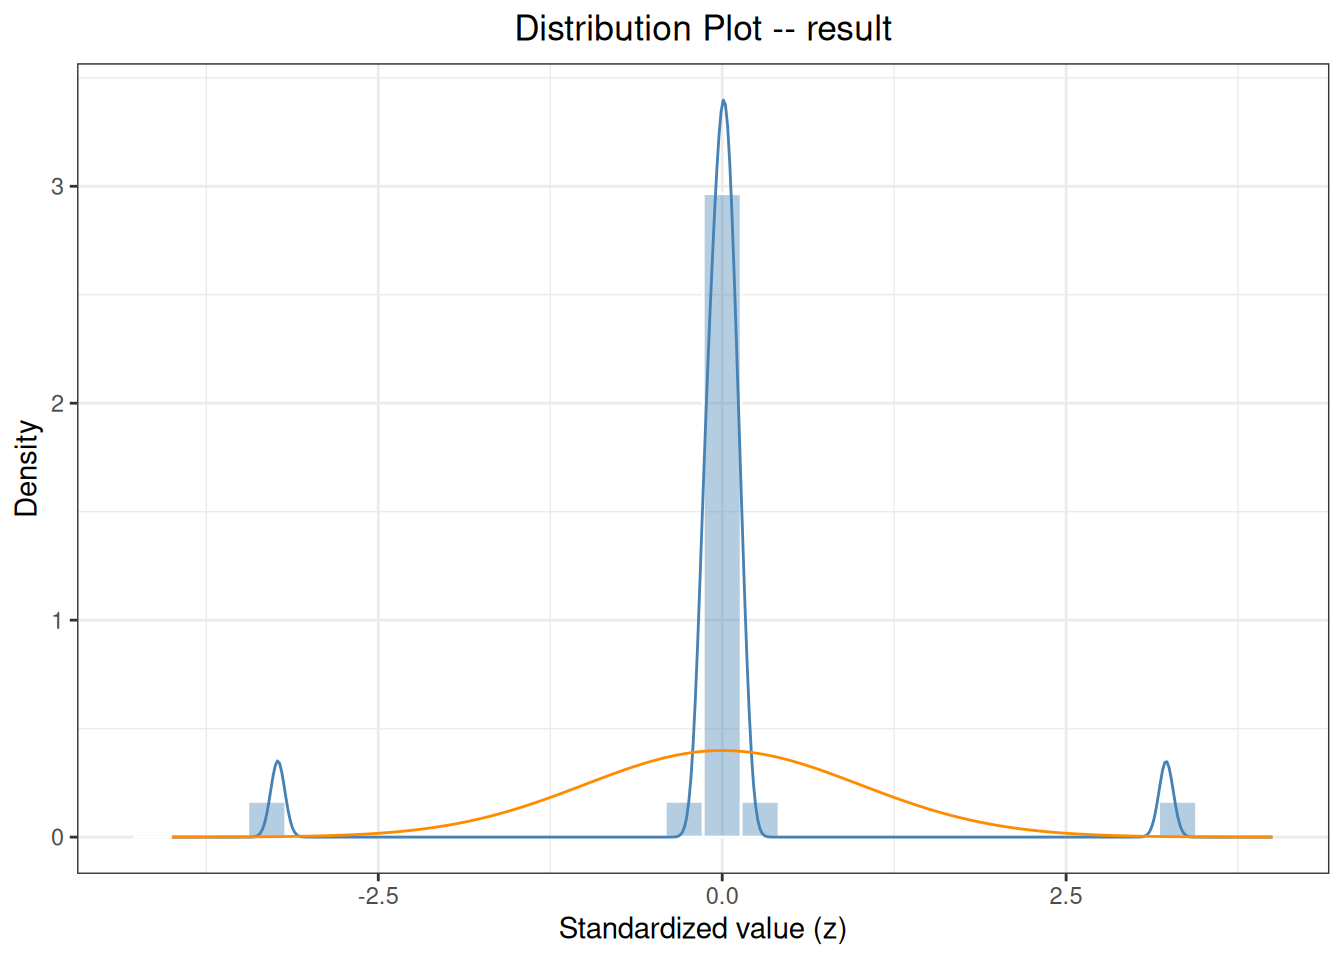
显著性水平为 \(\alpha=1-\texttt{level}\)。plot() 的 QQ 图和直方图用于识别偏态、重尾和混合分布;p 值随样本量高度变化,应与图形和数据产生过程共同解释。
outliers_test() 返回方法、统计量、P 值、候选异常值及索引;normal_test() 返回实际方法、统计量、P 值和样本量。
普通数据框同时包含多个分析物、样本水平或批次时,outliers_test() 和 normal_test() 不会自动分组。可先调用 split_by_factors(data, variable="analyte"),再用 lapply() 对各子数据框执行完全相同的预设检验;每组结果应分别报告,不能把各组观测合并后检验。
outlier(mcr, type="difference") 检验成对差值,而 type="candidate" 或 "reference" 检验单方法结果;百分比差还受分母选择影响。outlier(precision) 和 normal(precision) 按 by 定义的样本组处理测量结果,不会自动按天或运行重构独立残差。对象级诊断保存到对象槽中,每次调用后必须重新赋值。
对象级 outlier()、normal() 返回写入诊断槽的更新对象;plot() 返回 ggplot 对象。
library(ivdtools)构造一组包含极端观测的教学数据。正式项目应先保存原始数据和数据字典,再进行任何排除或变换。
diagnostic_data <- data.frame(
  sample_id = seq_len(22),
  result = c(99.8, 100.4, 99.7, 100.1, 100.0, 99.9,
             100.3, 100.2, 99.6, 100.1, 100.0, 99.8,
             100.2, 99.9, 100.1, 100.0, 99.7, 100.3,
             100.1, 99.9, 108.0, 92.0)
)

grubbs_result <- outliers_test(diagnostic_data, "result", method = "grubbs")
iqr_result <- outliers_test(diagnostic_data, "result", method = "iqr")
normality_result <- normal_test(diagnostic_data, "result", method = "shapiro")

grubbs_result
Grubbs Outliers Test
Data: diagnostic_data
Column: result (n = 22, missing = 0)
Parameters: alpha = 0.05
Outliers: 1
Index Value G stat Critical
-------------------------------------------
22 92.0000 3.2308 2.7577iqr_resultIQR Outliers Test
Data: diagnostic_data
Column: result (n = 22, missing = 0)
Parameters: coef = 1.5
Outliers: 2
Index Value
---------------------
21 108.0000
22 92.0000
fences: [99.3000, 100.7000]normality_result
Normality Test
  Data:   diagnostic_data
  Column: result (n = 22, missing = 0)
  Method:     Shapiro-Wilk

  W = 0.5059, p = 0.0000
outliers_test() 返回候选异常值的行号和值;normal_test() 返回实际使用的检验方法、统计量和 p 值。p 值不能单独决定是否删除观测,尤其在样本量很大或很小时都需要结合图形、实验记录和研究目的解释。
plot(normality_result, type = c("qq", "his"))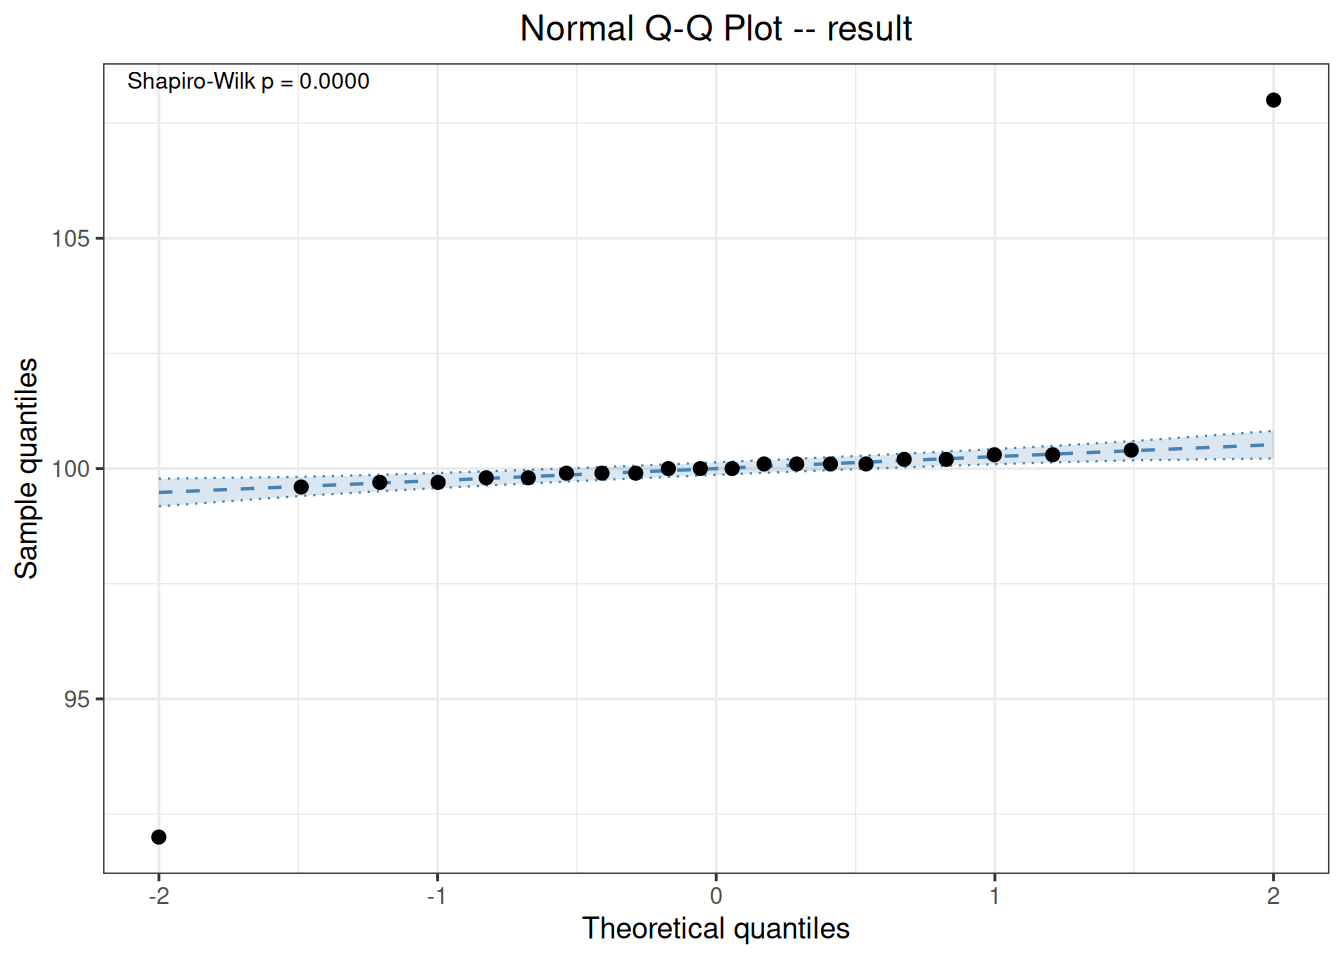
方法学比较中的异常值应明确异常量是候选方法、参考方法还是配对差值。先建立 mcr 对象,再指定检测类型:
mcr_data <- data.frame(
  id = 1:12,
  candidate = c(10.1, 11.2, 12.0, 13.1, 14.0, 15.2,
                16.1, 17.0, 18.2, 19.0, 20.1, 28.0),
  reference = c(10.0, 11.0, 12.1, 13.0, 14.1, 15.0,
                16.0, 17.1, 18.0, 19.1, 20.0, 21.0)
)

mcr_result <- mcr(
  mcr_data, id = "id", candidate = "candidate", reference = "reference"
)
mcr_result <- outlier(mcr_result, method = "grubbs", type = "difference")
Outlier
  Method: grubbs
  Data:   Difference (candidate - reference)
  Alpha:  0.05

  1 outlier(s) found:
  Row                Value   Statistic  Critical
   --------------------------------------------------
  12                7.0000      3.1694  2.4116
检测到候选异常值后,应回查样本身份、运行顺序、试剂批次、仪器报警和原始图谱。排除必须有可追溯的技术理由,并同时报告保留和排除该观测时的主要结果。
精密度设计中的诊断应保留实验层级;不能把同一运行内的重复结果当作彼此独立的患者样本。
precision_data <- data.frame(
  sample = rep("level_1", 20),
  day = factor(rep(1:5, each = 4)),
  run = factor(rep(rep(1:2, each = 2), 5)),
  result = c(99.8, 100.1, 100.0, 99.9, 100.2, 100.0, 100.1, 99.8,
             99.7, 100.0, 99.9, 100.1, 100.3, 100.1, 100.0, 100.2,
             99.8, 100.0, 100.1, 100.0)
)

precision_result <- precision(precision_data, result ~ day/run, by = "sample")
precision_result <- outlier(precision_result, method = "grubbs")
Outlier detection -- Grubbs (alpha = 0.05)
No outliers detected.precision_result <- normal(precision_result, method = "shapiro")Normality test -- Shapiro-Wilk
Sample n Method Statistic p-value
---------------------------------------------------------------------------
level_1 20 Shapiro-Wilk W=0.9550 0.4497标准以 18.85、20.38、21.97、22.32 ng/mL 演示 Grubbs 与双侧 Dixon 检验,结论均为无离群值。这两个入口 outliers_test() 直接对应,不需要另写统计量公式。
yyt1789_4_outlier <- data.frame(
  sample = 1:4,
  result = c(18.85, 20.38, 21.97, 22.32)
)

yyt1789_4_grubbs <- ivdtools::outliers_test(
  yyt1789_4_outlier, "result", method = "grubbs", alpha = 0.05
)
yyt1789_4_grubbs
Grubbs Outliers Test
Data: yyt1789_4_outlier
Column: result (n = 4, missing = 0)
Parameters: alpha = 0.05
Outliers: 0
No outliers detected.yyt1789_4_dixon <- ivdtools::outliers_test(
yyt1789_4_outlier, "result", method = "dixon", alpha = 0.05,
type = "both"
)
yyt1789_4_dixonDixon Q Outliers Test
Data: yyt1789_4_outlier
Column: result (n = 4, missing = 0)
Parameters: alpha = 0.05, type = both
Outliers: 0
No outliers detected.两种包函数均报告 0 个离群值,与标准一致。标准显示的 Grubbs 统计量为低端 1.2727、高端 0.9028,Dixon 统计量为低端 0.441、高端 0.101;当前打印方法只给离群位置和结论,不公开这些中间统计量,所以不能把“结论一致”写成“所有中间量均已复现”。